
人間のRGB動画から両手の器用さを事前学習
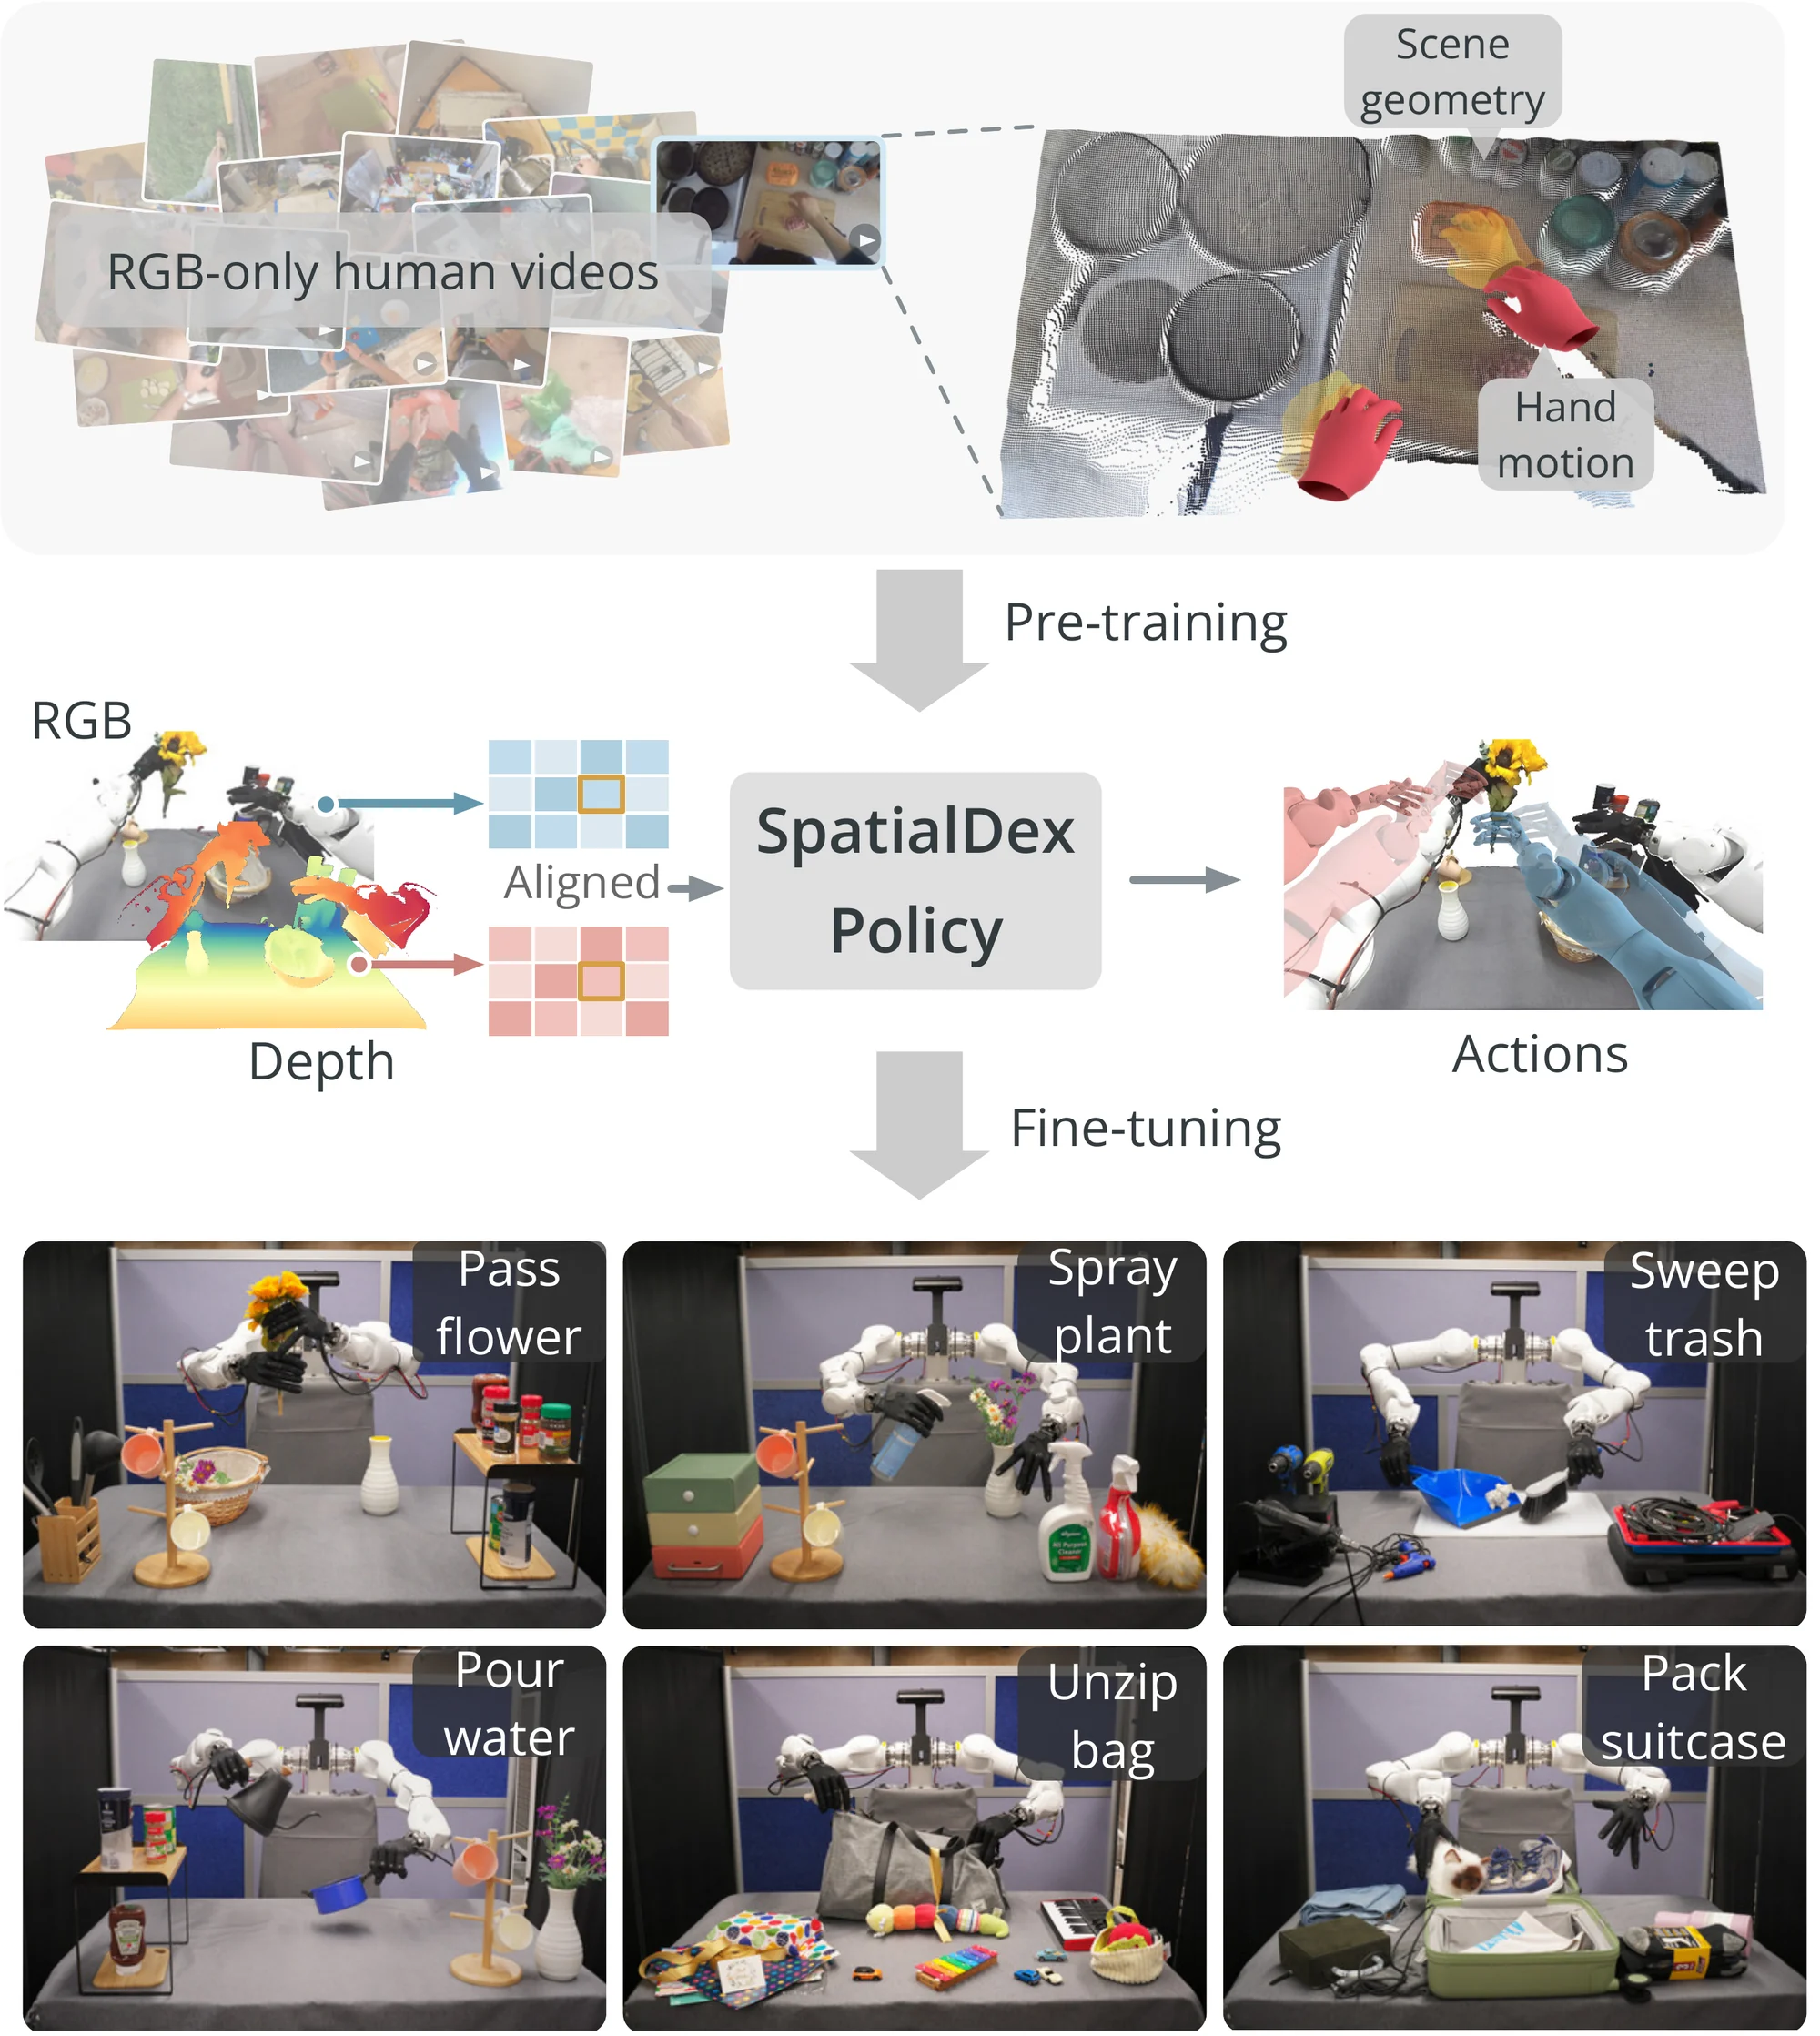
RGBのみの人間動画から3D空間に根ざした両手の器用操作を学ぶ枠組み「SpatialDex」が発表された。各動画から場面の形状を復元して手の動きを推定し、手の大きさの事前知識でスケールを揃える。復元した形状は方策の入力と予測対象の両方に使い、視覚言語モデルのトークンに融合する。100万クリップで事前学習し、少数のロボット実演で微調整した結果、シミュレーション9課題で最先端手法を16.5ポイント、実機の両手6課題で38.3ポイント上回った。形状を使わず手の動きだけで事前学習した場合との比較でも、成功率が14.2ポイント向上している。
HN 4
 プロジェクトページ · プロジェクトページSpatialDex: 3D-Grounded Bimanual Dexterity from RGB-Only Human Videosspatial-dex.github.io
画像は配信元が共有用に設定したもの(OGP画像)を表示しています。記事本文や写真の転載はしていません。
出典
見出しと要約はAIが作成しています。正確な情報は公式ページ・元記事をご確認ください。